

Nvidia mira respostas mais rápidas com chips da Groq 3 LPX
Nvidia coloca o Groq 3 em produção e aposta em chips de baixa latência para acelerar respostas de IA em data centers ainda este ano O post Nvidia mira respostas mais rápidas com chips da Groq 3 LPX apareceu primeiro em Olhar Digital .

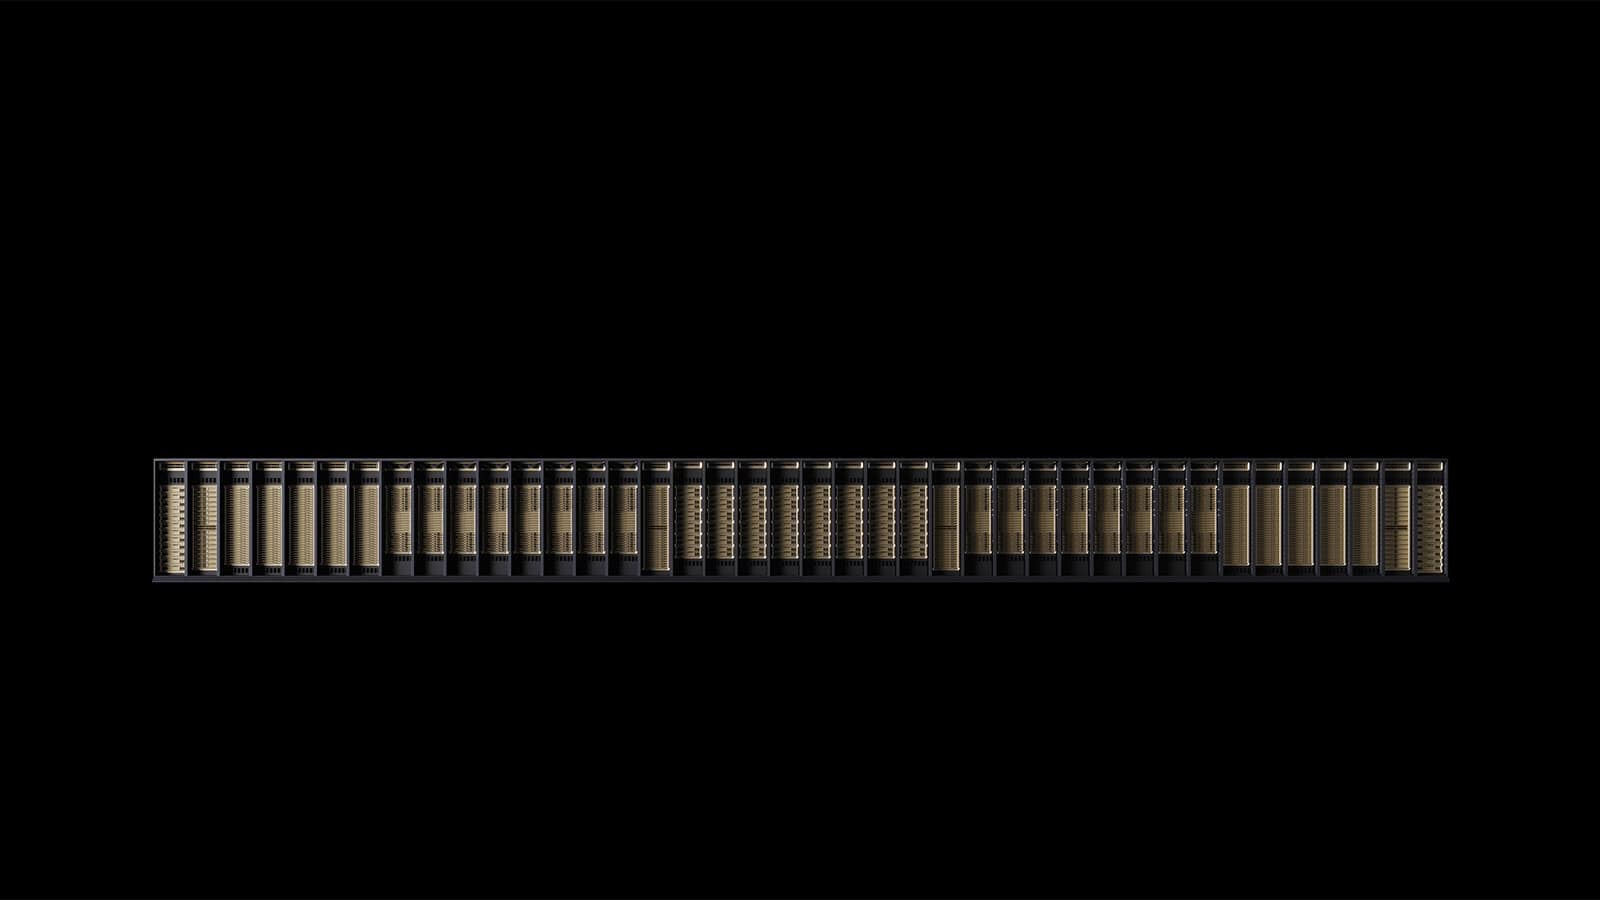
A Nvidia colocou o rack Groq 3 LPX em produção e pretende deixá-lo operacional ainda este ano na neocloud Nebius. A tecnologia chegou à empresa após a compra de ativos da Groq por US$ 20 bilhões (cerca de R$ 103 bilhões), a maior aquisição já realizada pela Nvidia.
O foco está na inferência de baixa latência, capaz de reduzir o intervalo entre o pedido do usuário e a resposta de um sistema de IA. A característica é especialmente relevante em aplicações de programação, nas quais atrasos podem ser percebidos rapidamente.
Na Nebius, os racks Groq 3 LPX serão instalados junto dos processadores Vera e das GPUs Rubin. Dion Harris, diretor sênior da Nvidia, afirmou que os equipamentos estarão disponíveis ainda este ano.

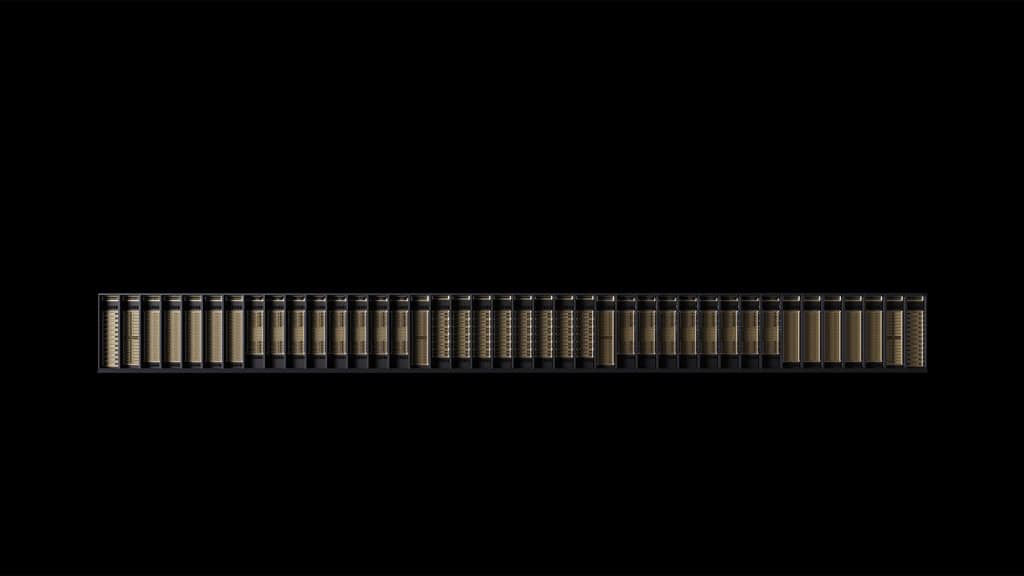
A arquitetura da Groq coloca 500 MB de memória SRAM de alta velocidade diretamente no chip. Com isso, a tecnologia busca diminuir gargalos provocados pelo acesso à memória durante a execução dos modelos.
Cada rack reúne 256 chips Groq 3. De acordo com a Nvidia, o sistema chega a 3.400 tokens por segundo, resultado baseado em um benchmark da Artificial Analysis.
A tecnologia da Groq cumpre uma função mais específica. Os chips se concentram principalmente na etapa de “decode” da inferência, responsável pela geração dos tokens que compõem a resposta de um modelo.
As GPUs continuam sendo usadas em treinamento e inferência e têm maior flexibilidade para acompanhar diferentes modelos e tecnologias. Para Harris, uma tecnologia não precisa eliminar a outra:
Isso não significa substituir as GPUs. Trata-se de usar o preço certo e o processador certo para a parte certa da carga de trabalho.
A proposta, portanto, é dividir as tarefas conforme as características de cada processador.

A Nvidia disputa esse mercado com empresas que também procuram acelerar a geração de respostas por IA. A AMD anunciou que vai integrar seus sistemas em escala de rack a chips da Cerebras, que recentemente abriu capital.
A OpenAI também entrou nessa corrida. Seu modo Ultrafast promete 750 tokens por segundo e é “alimentado pela Cerebras”.
A Nvidia, enquanto isso, amplia os envios dos sistemas Vera Rubin, cuja produção começou anteriormente. Em março, durante a apresentação dos sistemas Vera Rubin e Groq 3 LPX, Jensen Huang disse que reservaria um quarto do espaço de data centers destinado a aplicações de programação para os chips da Groq.
“O restante do meu data center é 100% Vera Rubin”, afirmou Huang na ocasião.
Com a Groq, a Nvidia passa a ter uma alternativa específica para acelerar uma etapa da inferência. As GPUs seguem como a base de seus sistemas, enquanto os novos racks assumem tarefas em que o tempo de resposta é um fator decisivo.
O post Nvidia mira respostas mais rápidas com chips da Groq 3 LPX apareceu primeiro em Olhar Digital .


Publicado originalmente por Olhar Digital. Leia a matéria completa em https://olhardigital.com.br/2026/08/24/inteligencia-artificial/nvidia-mira-respostas-mais-rapidas-com-chips-da-groq-3-lpx/.
A estratégia da Nvidia é combinar tecnologias, não escolher uma só: Groq para baixa latência e GPUs para cargas mais amplas. – Imagem: Samuel Boivin/Shutterstock — Foto: Olhar Digital
Compartilhe
Espalhe essa notícia